🧬 模型架构
| 维度 | V4 Flash | V4 Pro |
|---|---|---|
| 总参数量 | 284B | 1.6T |
| 激活参数量 | 13B | 49B |
| 架构 | MoE(混合专家)+ CSA + HCA 混合注意力 | |
| 上下文长度 | 1M tokens | |
| 最大输出 | 384K tokens | |
| 推理模式 | 3 种:Non-Think / Think High / Think Max | |
| 预训练数据 | 32T tokens | 33T tokens |
⚡ 混合注意力效率:1M 上下文下 Pro 仅需 V3.2 的 27% FLOPs 和 10% KV Cache;Flash 更极致,仅需 10% FLOPs 和 7% KV Cache [技术报告 §1]
💰 官方 API 定价 (每 1M tokens) [官方定价页]
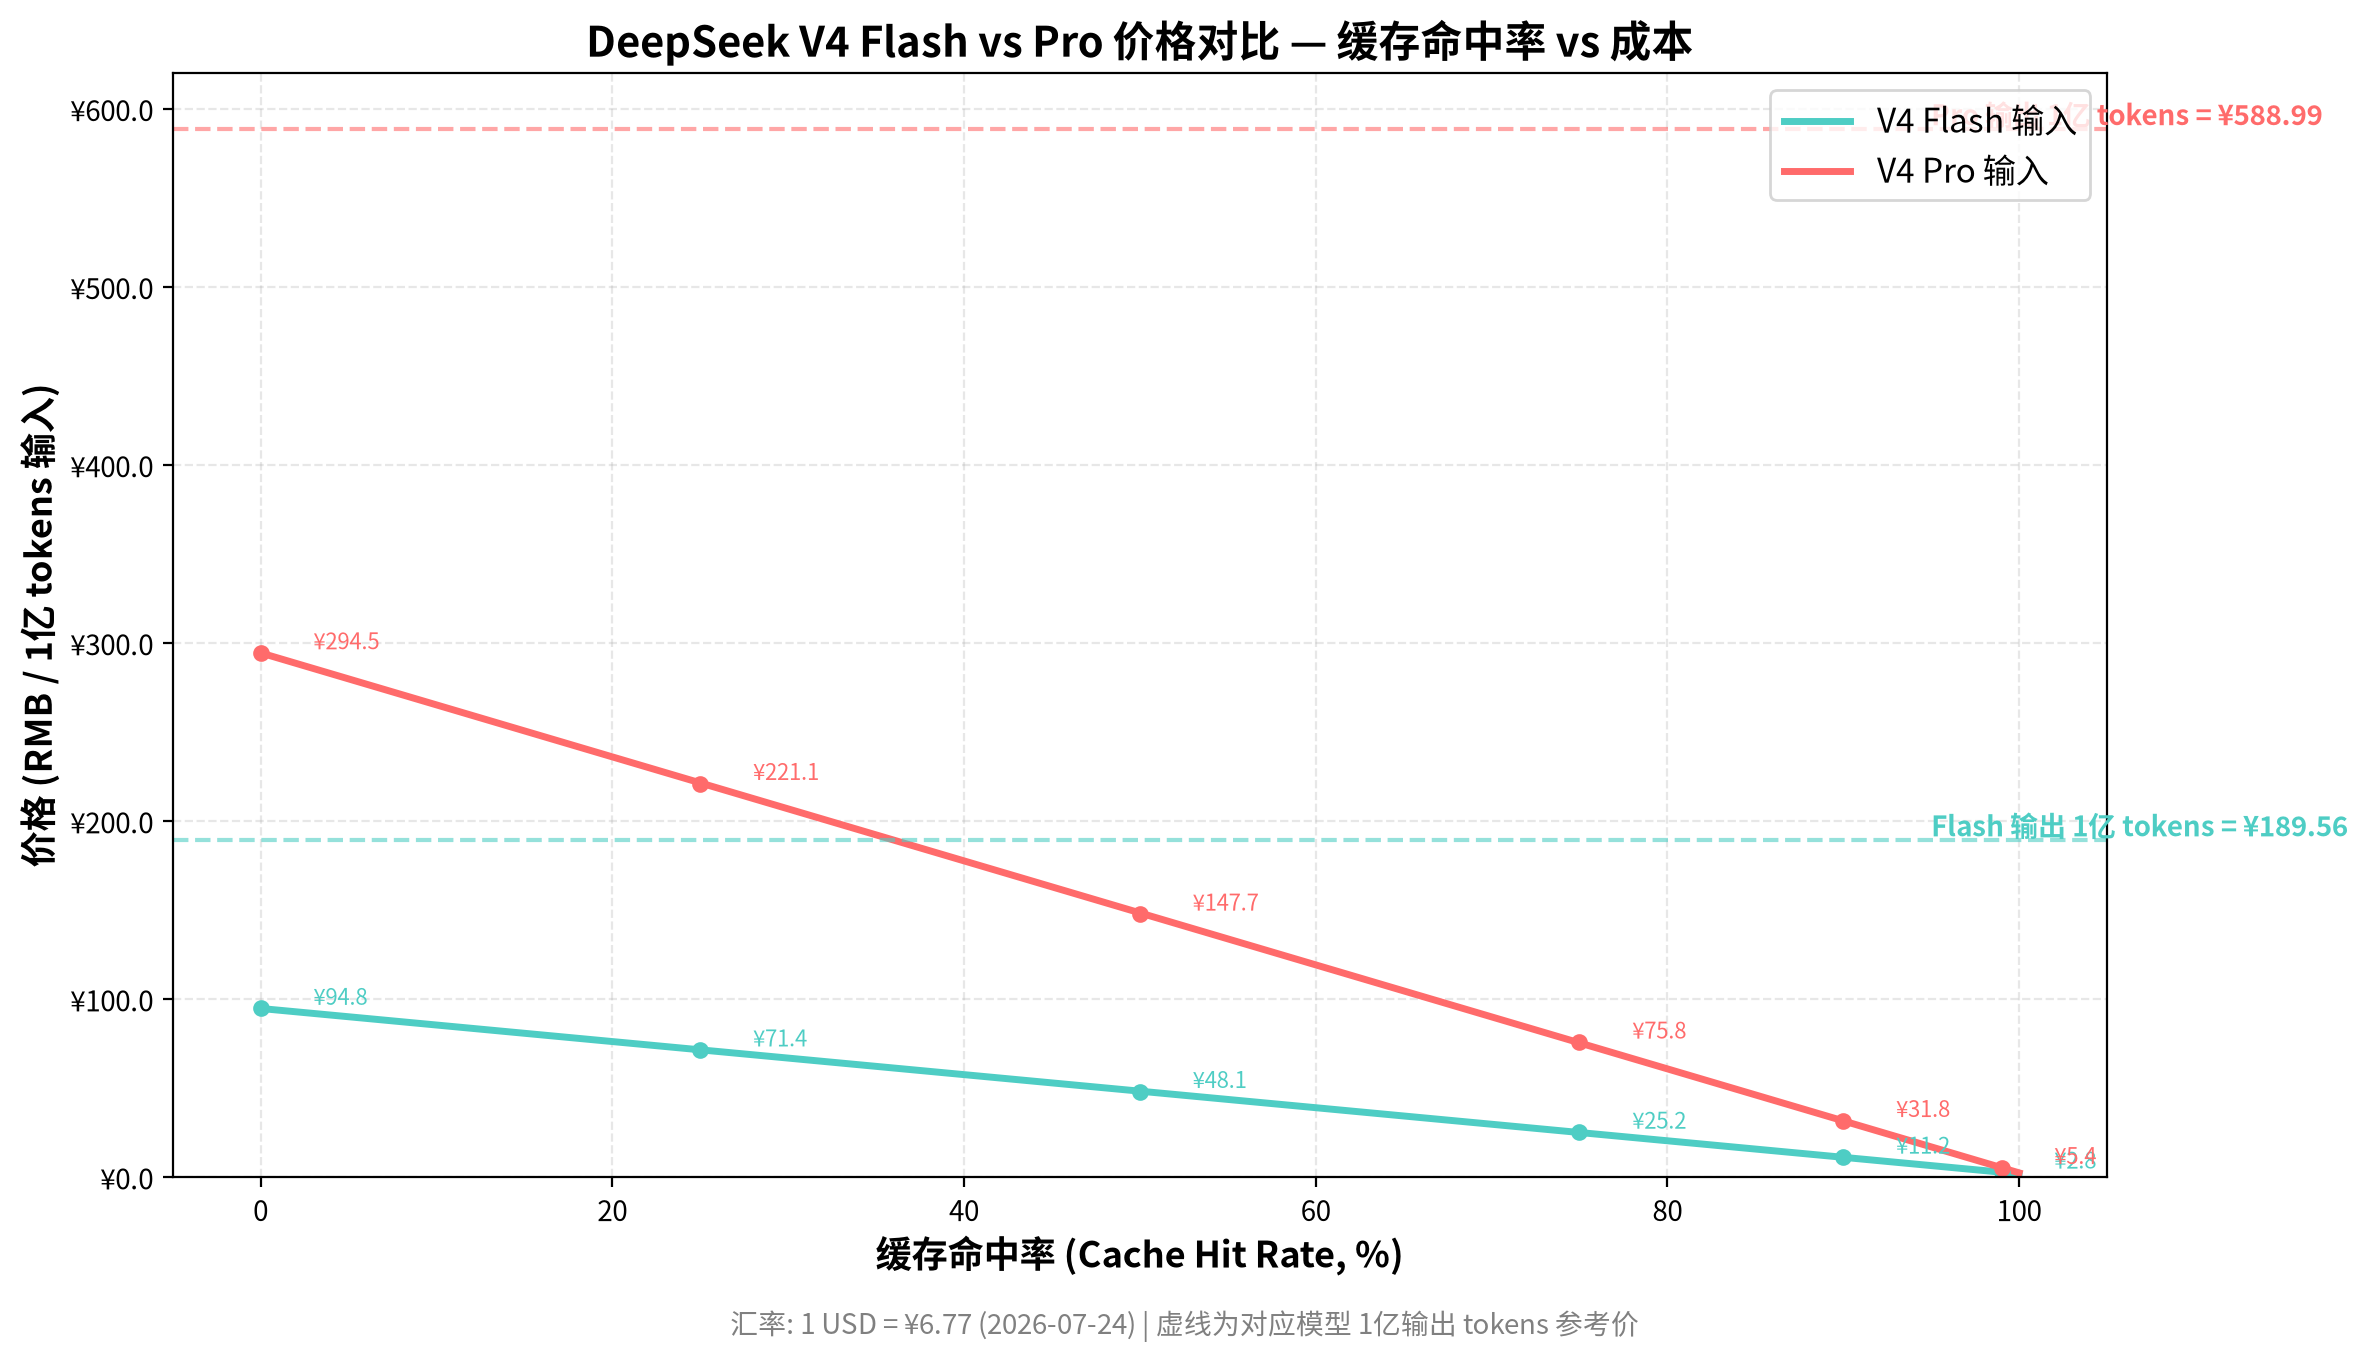
📈 缓存命中率 vs 成本
每一亿输入 tokens 的总价格随缓存命中率变化。虚线为对应模型输出 1 亿 tokens 的参考价。 汇率:1 USD = ¥6.77(2026-07-24)。
🧠 三种思考模式详解
[官方思考模式指南]
V4 系列有 3 级推理力度,Flash 和 Pro 都支持,通过 extra_body 参数切换:
| 模式 | 行为 | 速度 | 典型 token 消耗 | 适合 |
|---|---|---|---|---|
| Non-Think | 直接回答,无 CoT 推理链条 | 🚀 最快 | ~200–500 tokens | 日常问答、分类、摘要、简单任务 |
| Think High | 受控 CoT 推理,budget_tokens 可配(默认启用) |
⚡ 中等 | ~2,000–8,000 tokens | 复杂问题求解、多步推理、代码调试 |
| Think Max | 穷尽式推理,需设特殊 system prompt,建议 ≥384K 上下文 | 🐢 最慢 | ~8,000–50,000+ tokens | 竞赛数学、前沿编程、科学研究 |
📊 思考模式 × 模型:完整基准对比
[技术报告 §5.3]以下数据来自 DeepSeek 技术报告(arxiv 2606.19348)及公开评测。绿色 = 该行最优,粗体 = 当前模式下表现最好的配置。
🔹 V4-Flash:Non-Think → Think High → Think Max
| 评测基准 | Non-Think | Think High | Think Max | 提升幅度 |
|---|---|---|---|---|
| MMLU-Pro(知识) | 83.0 | 86.4 | 86.2 | +3.4 |
| GPQA Diamond(科学推理) | 71.2 | 87.4 | 88.1 | +16.9 🚀 |
| HLE(人类最后考试) | 8.1 | 29.4 | 34.8 | +26.7 🚀🚀 |
| LiveCodeBench(编程) | 55.2 | 88.4 | 91.6 | +36.4 🚀🚀 |
| Codeforces(竞赛编程 Rating) | — | 2816 | 3052 | — |
| HMMT 2026 Feb(数学竞赛) | 40.8 | 91.9 | 94.8 | +54.0 🚀🚀 |
🔹 V4-Pro:Non-Think vs Think Max
| 评测基准 | Non-Think | Think Max | 提升幅度 |
|---|---|---|---|
| GPQA Diamond(科学推理) | 72.9 | 90.1 | +17.2 🚀 |
| LiveCodeBench(编程) | 56.8 | 93.5 | +36.7 🚀🚀 |
| Codeforces(竞赛编程 Rating) | — | 3206 | — |
| HMMT 2026 Feb(数学竞赛) | 31.7 | 95.2 | +63.5 🚀🚀 |
🔸 同模式对比:Flash vs Pro 在 Non-Think / Think Max 下的差距
| 评测基准 | Non-Think | Think Max | ||
|---|---|---|---|---|
| Flash | Pro | Flash | Pro | |
| GPQA Diamond | 71.2 | 72.9 | 88.1 | 90.1 |
| LiveCodeBench | 55.2 | 56.8 | 91.6 | 93.5 |
| Codeforces Rating | — | — | 3052 | 3206 |
| HMMT 2026 Feb | 40.8 | 31.7 | 94.8 | 95.2 |
| 知识类:MMLU-Pro / GPQA Diamond Non-Think | Non-Think 下 Flash 与 Pro 差距极小(1–2分),甚至 Flash 的 HMMT 还反超 Pro | Think Max 下 Pro 全面领先,但差距不大(1.9–4.2分) | ||
🔸 思考模式对知识类 vs 推理类的影响差异
| 任务类型 | Non-Think → Think Max 变化(Flash) | Non-Think → Think Max 变化(Pro) | 解读 |
|---|---|---|---|
| 知识类(MMLU-Pro) | 83.0 → 86.2 (+3.2) | — | 思考对知识类帮助有限 |
| 科学推理(GPQA) | 71.2 → 88.1 (+16.9) | 72.9 → 90.1 (+17.2) | 大幅提升,两模型幅度相当 |
| 编程(LiveCodeBench) | 55.2 → 91.6 (+36.4) | 56.8 → 93.5 (+36.7) | 思考带来质的飞跃 |
| 竞赛数学(HMMT) | 40.8 → 94.8 (+54.0) | 31.7 → 95.2 (+63.5) | 思考从"不及格"拉到"接近满分" |
📈 综合智能指数
来自 Artificial Analysis Intelligence Index v4.1(9 项评测综合),以及 Kilo FlowGraph 复杂工程实测:
Kilo FlowGraph 复杂后端工程实测:Flash Think High 60/100 · Pro Think High 77/100(Claude Opus 4.7 为 91)
📋 关键基准总表
| 评测基准 | Flash 默认(High) | Flash Max | Pro 默认(High) | Pro Max |
|---|---|---|---|---|
| MMLU-Pro | 86.4 | 86.2 | — | 87.5 |
| GPQA Diamond | 87.4 | 88.1 | — | 90.1 |
| SWE-bench Verified | — | 79.0 | — | 80.6 |
| SkillsBench v1.1 | — | 44.7 | — | 50.1 |
| LiveCodeBench | 88.4 | 91.6 | — | 93.5 |
| Codeforces Rating | 2816 | 3052 | — | 3206 |
| GSM8K | — | — | — | 92.6 |
🔬 第三方实测详情
✅ Kilo AI:FlowGraph 复杂后端工程
| 维度 | Flash | Pro |
|---|---|---|
| 综合评分 | 60 / 100 | 77 / 100 |
| 单次运行成本 | ~$0.02 | ~$0.28 |
| 核心路由 | ❌ API 挂在错误路径 | ✅ 基本正确 |
| 租赁/并发处理 | ❌ 过期 lease 仍可完成步骤 | ❌ 同 Flash + 队列阻塞 |
| 工具调用可靠性 | ✅ 超预期 | ✅ 良好 |
💡 Kilo 评价:Flash 的"贵效比"极低——$0.02 跑完整套测试,每分成本仅为 Opus 4.7 的 1/100。Pro 介于 Opus 4.7(91分)和 Kimi K2.6(68分)之间。两者的工具调用能力都超出预期。
✅ Towards AI:20 个真实任务实测
✅ Reddit 社区:用户口碑
"V4 Pro 相当于 V3.2 开到 12 档。Flash 更快、更便宜,能达到 Pro 大约 90% 的水平。Pro 在细微处理和理解深度上明显更强。"— r/SillyTavernAI
"Flash 输出速度是 Pro 的 3 倍以上。Flash 缺一些沉浸式细节,但篇幅比 V3.2 多 45%+。"
✅ NIST CAISI 评估
NIST 的 CAISI 机构对 V4-Pro 进行了独立评估,指出其在基准测试上具有与美国前沿模型竞争的潜力,同时也关注到安全评估方面的考量。
🎯 选型指南
选 Flash 当主力
- 日常对话、翻译、文案、代码补全
- 高并发产品(AI SaaS、客服、批量处理)
- 成本敏感项目
- 需超快速响应的场景
- 简单到中等复杂度的 Agent 任务
- 非思考模式下性价比无敌
选 Pro 当王牌
- 复杂推理(数学、科学、逻辑)
- 深度代码工程 + 多文件协调
- Agent 智能体工作流(Claude Code、OpenClaw)
- 研究级任务 / 长链推理
- 1M 上下文精准检索
- 比价格更在乎顶尖质量
🔥 思考模式 × 模型选择策略
| 任务难度 | 推荐配置 | 预期质量 | 估算成本(每次) |
|---|---|---|---|
| 简单(分类、摘要、翻译) | Flash Non-Think | 尚可 | ~$0.0001(¥0.0007) |
| 中等(代码生成、问答、规划) | Flash Think High | 优秀(Pro 的 ~90%) | ~$0.001(¥0.0068) |
| 困难(调试、复杂推理) | Flash Think Max | 接近 Pro 水平 | ~$0.005–$0.014(¥0.034–¥0.095) |
| 极难(竞赛数学、科研) | Pro Think Max | 顶尖 | ~$0.02–$0.05(¥0.14–¥0.34) |
🔗 原始来源
- DeepSeek-V4 技术报告 — arxiv 2606.19348
- DeepSeek-V4-Pro Model Card — Hugging Face
- DeepSeek-V4-Flash Model Card — Hugging Face
- DeepSeek API 定价 — api-docs.deepseek.com
- DeepSeek V4 发布公告 — api-docs.deepseek.com
- DeepSeek 思考模式指南 — api-docs.deepseek.com
- Kilo AI 实测:DeepSeek V4 Pro vs Flash vs Opus 4.7 vs Kimi K2.6
- Framia:DeepSeek V4 三种思考模式详解
- Towards AI:20 个真实任务实测 V4 四种配置
- Artificial Analysis:Flash vs Pro 智能指数对比
- Lightning AI:DeepSeek V4 性价比分析
- Reddit r/SillyTavernAI 社区讨论
- Reddit r/LocalLLaMA 智能密度讨论
所有数据引用截至 2026-07 · 汇率 ¥6.78/$1